Cómo está montado Albgott de verdad.
El hardware, la red y los servicios reales, tras tres años de crecer pieza a pieza. Parte del montaje es irregular, y los motivos son más interesantes que un diagrama ordenado.
La conexión a internet
Internet llega a través de un equipo que no controlo. Mi contrato obliga a mantener el router del operador, así que el tráfico pasa por dos routers antes de llegar a algo que gestiono yo: primero el suyo y después el mío.
El mío es un MikroTik hEX S con RouterOS. Hace el enrutamiento, el NAT, el firewall y los dos túneles WireGuard, y no tiene Wi-Fi. Eso no fue un plan. Lo pedí sin mirarlo, se me pasó el plazo de devolución y más tarde me di cuenta de que el accidente era una buena regla: el equipo que aplica el firewall no debería ser también un punto de acceso. El Wi-Fi lo da un router viejo de un operador anterior, que guardo solo para eso.
Detrás del MikroTik, un switch gestionable TP-Link TL-SG608E lleva trunks 802.1Q a cada máquina, y cada una recibe solo las VLAN que necesita. Tres equipos haciendo lo que en un centro de datos haría uno solo, cada uno por un motivo distinto: uno por contrato, otro a propósito y otro por accidente.
Las máquinas
Nada de esto se compró para lo que hace. El clúster salió de hardware que ya tenía: un portátil gaming, un sobremesa de oficina retirado y una torre con más margen que los otros dos juntos. Los roles se asignaron a lo que había, y las especificaciones de abajo lo dejan ver.
Tres nodos Proxmox cargan con casi todo:
| Nodo | Hardware | RAM / Disco | Qué ejecuta |
|---|---|---|---|
| pve01 | Portátil reciclado (Asus GL502VS, GTX 1070 Mobile) | 32 GB · 500 GB SSD + 1 TB HDD | Proxies interno y de gestión, Jenkins, Infisical y herramientas de desarrollo |
| pve02 | Sobremesa de oficina retirado (Dell OptiPlex 7050) | 16 GB · 256 GB | Stack de observabilidad |
| pve03 | Torre Dell PowerEdge T160 | 64 GB · 8 TB en un solo disco | Bases de datos, almacenamiento de objetos y servicios públicos |
El reparto es desigual a propósito. pve02 ejecuta métricas y dashboards, que piden más E/S de disco que RAM, así que le tocó la máquina más pequeña. pve03 guarda el estado, así que tiene con diferencia más memoria y más disco. pve01 solo ejecuta cosas fáciles de reconstruir: un portátil no tiene memoria ECC ni fuente redundante, y sus bisagras no se pensaron para funcionar 24/7. Su GTX 1070 se queda en el host y se comparte con contenedores LXC mediante bind-mounts de dispositivo, así que un servidor de inferencia puede usarla sin que un passthrough con VFIO se la quite a todo lo demás.
Las máquinas tienen nombres nórdicos (odin, brokkr, eitri, thor) porque no cuesta nada y me gusta. En configuraciones, dashboards y alertas uso los aburridos (pve01, pve02, pve03, dns01), porque a las 3 de la madrugada "pve03" me dice qué es y "thor" no.
La gestión fuera de banda también es desigual. Solo pve03 tiene una de verdad: un iDRAC, accesible únicamente por la VPN de administración, que puede encender la máquina aunque el sistema operativo esté muerto. Con los otros dos, si uno se cuelga lo suficiente, la solución es ir hasta él y pulsar un botón.
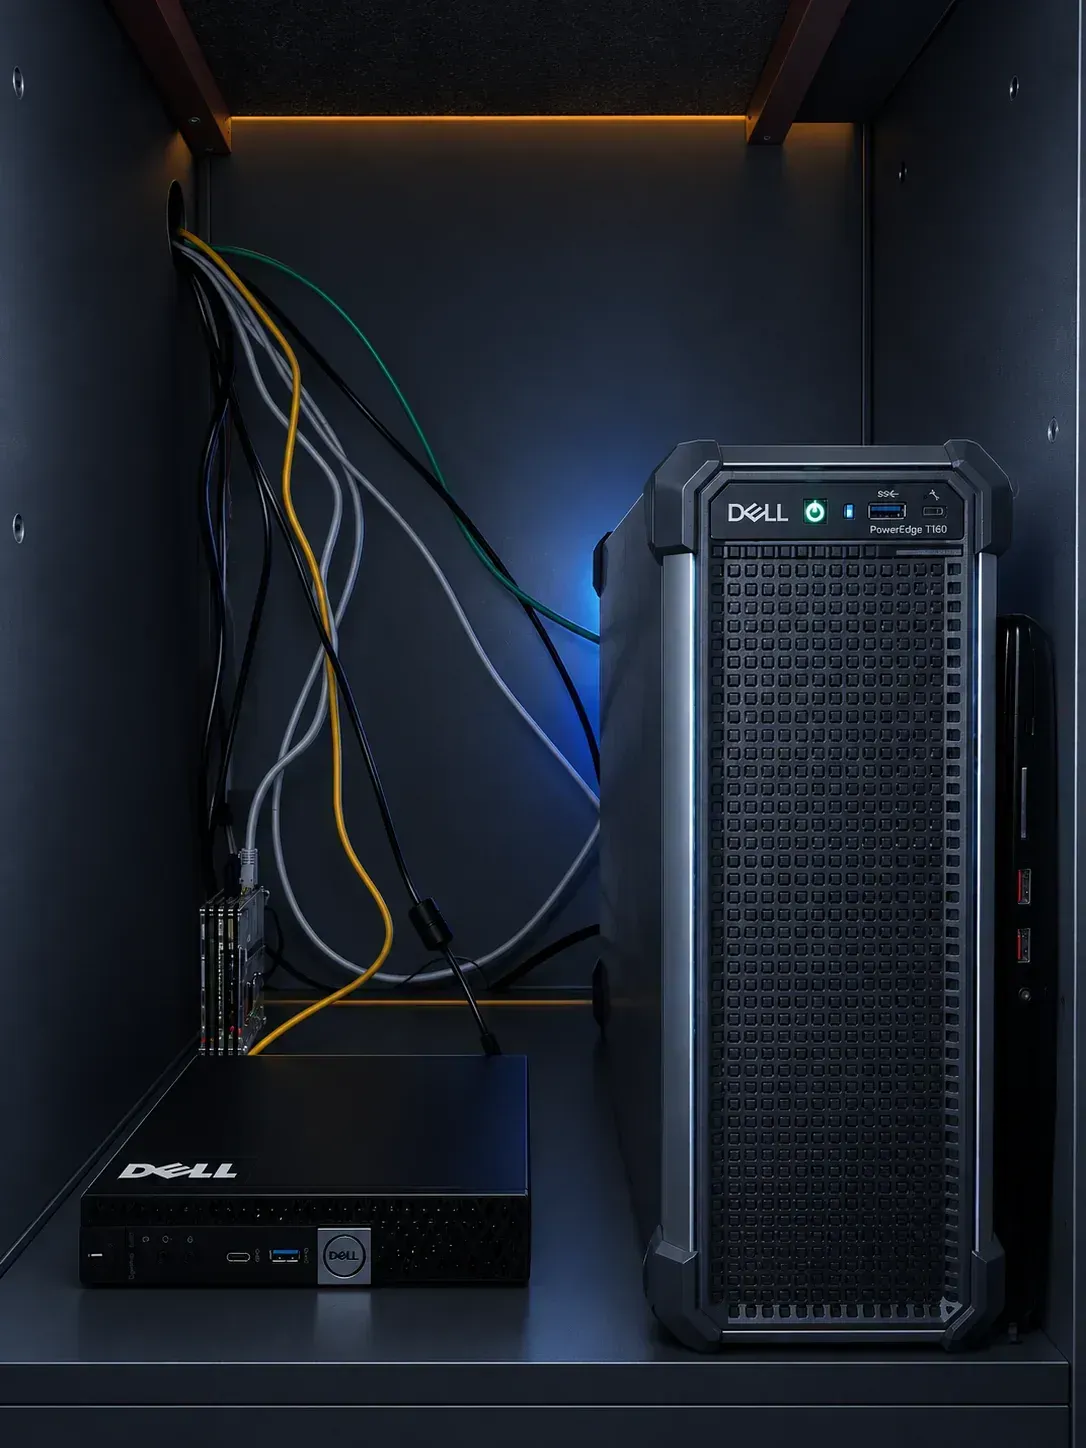
Hay una cuarta máquina que no es un nodo Proxmox: una Raspberry Pi 3B+ con el DNS primario de toda la red. Está siempre encendida y apenas consume, que es justo lo que necesita un DNS. Es lo siguiente.
Cómo se resuelven los nombres
Tengo dos servidores DNS porque una vez tuve uno. Se cayó, y un cliente se dio cuenta antes que yo. Los dos usan Technitium: el primario en la Raspberry Pi y el secundario en una VM de pve03. Responden por albgott.com, y todo lo demás sale hacia Quad9 por DNS sobre TLS, así que las consultas al exterior tampoco viajan en claro.
La pareja se sincroniza de la forma estándar: el primario envía un NOTIFY, el secundario descarga la zona con AXFR/IXFR y cada transferencia va autenticada con TSIG para que nadie pueda inyectar registros. Todos los cambios se hacen en el primario. El secundario solo existe para que los nombres sigan resolviendo si la Pi muere. DNS de manual, y aprendí por qué está en el manual.
Cómo se divide la red
Ocho VLAN, cada una una zona de confianza aplicada en el MikroTik. A qué puede llegar una máquina depende de en qué VLAN está y de nada más. El tráfico entre VLAN se deniega por defecto, y cada excepción es una regla construida con listas de direcciones de RouterOS: una lista de origen, una de destino y un puerto.
| Segmento | Función |
|---|---|
| Home | Dispositivos personales, fuera del espacio de direcciones de la infraestructura |
| Internal | La capa de aplicaciones, donde viven la mayoría de servicios |
| Data | Bases de datos y almacenamiento de objetos, difíciles de alcanzar a propósito |
| Corp | Equipos de trabajo |
| CI | Agentes de build, solo con salida a internet |
| Public | La DMZ, accesible desde internet solo a través de un proxy |
| Backup | Reservada para un sistema de copias que todavía no existe |
| Mgmt | DNS, consolas de los hipervisores y el resto del plano de control |
La lista importa menos que los motivos detrás de ella:
- Los datos están aislados a propósito. Nada llega a una base de datos o al almacenamiento de objetos si no hay una regla que nombre esa ruta exacta, y solo la tienen los pocos hosts que la necesitan.
- Public es una DMZ. Es accesible desde internet, pero solo puede reenviar a una lista corta de backends. Nunca se convierte en un camino hacia Internal, ni siquiera para servicios que corren en la misma máquina física.
- CI puede salir, pero nadie confía en ella. Los agentes de build necesitan descargar dependencias y subir imágenes. Eso es un permiso muy distinto a administrar algo, así que solo llegan a lo que necesita un despliegue y a nada del plano de gestión.
Junto a estas VLAN hay dos redes WireGuard para el acceso remoto, una para administración y otra para trabajo. Son overlays enrutados, así que un dispositivo remoto nunca entra en una VLAN; recibe una dirección que el firewall puede distinguir de los dispositivos locales. Cómo funciona el acceso está en /security.
Cómo entra el tráfico
Tres proxies inversos Caddy reciben el tráfico de entrada, uno por nivel de confianza. Un único proxy sería más sencillo, y esa sencillez es justo el problema.
| Nivel | Accesible desde | Qué hay detrás |
|---|---|---|
| Público | Internet (solo backends en lista blanca) | La única entrada desde internet. Los puertos 80 y 443 se redirigen a él, y él solo reenvía a una lista explícita de backends. |
| Interno | Redes de confianza y la VPN de trabajo | Herramientas pensadas solo para redes de confianza: dashboards, interfaces de monitorización, registros y utilidades de desarrollo. Es con diferencia el más usado de los tres, porque ahí vive lo que uso a diario. |
| Gestión | Solo la VPN de administración | El plano de control de la infraestructura: consolas de los hipervisores, equipo de red y gestión del hardware. Solo accesible desde la VPN de administración. |
La regla que hay detrás:
Entrar en una aplicación detrás del proxy interno nunca debería dar a nadie un camino hacia la consola de un hipervisor o hacia un switch.
Por eso el proxy de gestión es una instancia propia, en su propia VLAN y detrás de su propia VPN. Mi regla para cualquier cosa nueva: si puede reiniciar una máquina, cambiar la red o tocar hardware, va detrás del proxy de gestión. Para todo lo demás solo importa el público: redes de confianza o internet. La misma idea aparece en /security, aplicada a personas en lugar de proxies: es la razón de que el acceso remoto sean dos túneles y no uno con niveles de permiso.
Dos casos límite, porque explican la regla mejor que la propia regla:
- Un servicio puede estar detrás de dos proxies a propósito: las integraciones externas, como los webhooks, entran por el público, y las personas usan el interno. Mismo backend, dos públicos, dos conjuntos de reglas.
- Cuando un dispositivo de casa abre un nombre público como albgott.com, la petición iría a la IP de la WAN y no llegaría a ningún sitio. Un hairpin NAT en el MikroTik la devuelve al proxy público, así que la misma URL funciona desde dentro y desde fuera.
Dónde viven los datos
Todo lo que tiene estado (bases de datos y almacenamiento de objetos) está en la VLAN Data, en pve03. Solo tienen un camino de entrada los hosts, proxies y comprobaciones de monitorización que lo necesitan.
Hay dos piezas. RustFS es un almacenamiento de objetos compatible con S3 que sustituyó a MinIO tras su cambio de licencia y una interfaz de la edición comunitaria que empeoró bastante. Como habla la misma API de S3, no hubo que cambiar nada de lo que había encima. PostgreSQL funciona como dos instancias separadas, producción y desarrollo, en lugar de un servidor con dos bases de datos, para que una migración mala en desarrollo no pueda tocar producción. Las dos se monitorizan con postgres_exporter, con alertas de saturación de conexiones, deadlocks, sesiones largas en idle-in-transaction y bajo ratio de aciertos de caché.
Nada de esto tiene copia de seguridad todavía: todo vive en un único disco de 8 TB. Es lo primero del roadmap.
Qué hay funcionando
Encima de todo esto corren 38 servicios. El DNS, el router, el switch y los tres proxies ya están explicados arriba. Abajo está todo lo demás, agrupado por función, con una línea sobre por qué está cada uno.
El proveedor de identidad. Hoy el SSO con MFA protege el stack de monitorización, y el resto de servicios van pasando por él uno a uno.
Un segundo proveedor OIDC, multi-tenant, para aplicaciones públicas que necesiten sus propios usuarios.
Adonde se están moviendo los secretos, para que dejen de vivir en ficheros de configuración en texto plano.
Recoge métricas de cada target cada 15 segundos y evalúa las reglas de alerta.
Guarda durante 30 días los logs que Grafana Alloy envía desde cada host.
Me manda las alertas al móvil por Telegram, para enterarme de los problemas antes que un cliente.
Los dashboards que miro de verdad cada día.
Comprueba desde fuera si los endpoints públicos responden, sin depender de Prometheus.
Automatización de flujos para pequeños trabajos que no merecen un servicio propio.
Las pequeñas utilidades de desarrollo que si no buscaría en webs cualquiera.
Unir, dividir y convertir PDF sin subirlos a ningún sitio.
Una interfaz sobre los hosts Docker, para no tener que entrar por SSH solo para mirar un contenedor.
Mi propia nube de archivos. Sustituyó a Google Drive, uno de los motivos por los que empezó todo esto.
La fototeca que uso cada día.
Una app para llevar el registro de mis libros, hecha por mí. Pequeña, pero mía de principio a fin.
En el día a día, un dashboard self-hosted lo une todo: cada enlace interno en un solo sitio, con estadísticas en vivo de cada nodo.
Lo siguiente: /security explica cómo se controla el acceso a todo esto, y /operations cómo se mantiene funcionando. Nada está terminado; /roadmap recoge lo que sigue pendiente, en orden.